DisKo steht für Diversitäts-Korpus und ist ein literaturwissenschaftliches Projekt mit Digital-Humanities-Komponente. Mit Methoden des maschinellen Lernens wollen wir einen Algorithmus
Short description of the project
Das Ziel des Projektes ist, unser Verständnis von quantitativen, vergleichenden Methoden der Textanalyse zu verbessern. Der Schwerpunkt wird auf statistischen Distinktivitätsmaße liegen, die es den Forschern ermöglichen, Merkmale zu extrahieren, die charakteristisch für eine Textsammlung im Vergleich zu einer anderen Textsammlung sind.
Wir wollen unser Verständnis dafür verbessern, wie solche Distinktivitätsmaße funktionieren, wenn sie für mittelgroße bis große literarische Textsammlungen verwendet werden. Wir möchten dies auf empirische, datengestützte Weise tun, indem wir Benchmark-Korpora und verschiedene Evaluierungsstrategien einsetzen sowie eine eingehende Anwendungsstudie zum französischen Gegenwartsroman durchführen. Das daraus resultierende Wissen möchten wir in insbesondere in der Computerlinguistik und den Computational Literary Studies verbreiten.
Project content
Der Vergleich als methodisches und epistemologisches Paradigma ist in den Geisteswissenschaften tief verankert. Ob in der qualitativen oder quantitativen Forschung – über das Vergleichen lassen sich Ähnlichkeiten und Unterschiede, Affinitäten und Kontraste herausstellen; das Vergleichen schärft das Auge des Betrachters und Analysen gewinnen an Kontur und Aussagekraft. Vor diesem Hintergrund soll die hier beschriebene Forschung unser Verständnis von quantitativen, vergleichenden Analysemethoden zweier oder mehrerer Textsammlungen im Bereich der Digitalen Literaturwissenschaften verbessern. Der Fokus wird dabei auf einem zentralen Verfahren im Bereich der quantitativen, vergleichenden Analysen liegen: statistische Distinktivitätsmaße, die es Forschern ermöglichen, Elemente (z.B. Wortformen oder Wortarten) zu bestimmen, die charakteristisch für eine Textgruppe im Vergleich mit einer anderen Textgruppe sind. In so unterschiedlichen Bereichen wie Information Retrieval, Computerlinguistik oder den Digitalen Literaturwissenschaften ist ein breites Spektrum an statistischen Distinktivitätsmaßen entwickelt worden. Dabei können drei Typen von Maßen unterschieden werden, denen jeweils unterschiedliche Informationen zugrunde liegen.
Beim ersten Typ werden die relativen Häufigkeiten von Merkmalen in jeder der beiden Textgruppen verglichen (bspw. beim log-likelihood-Test). Beim zweiten Typ werden die Verteilungen der Häufigkeiten von Merkmalen in den einzelnen Texten beider Textgruppen ermittelt (bspw. beim t-Test). Beim dritten Typ wird die Dispersion der Merkmale über alle Texte hinweg in jeder Gruppe untersucht, d.h. wie gleichmäßig die Merkmale in jeder Gruppe von Texten verteilt sind (bspw. bei Zeta).
Um ein tieferes Verständnis der verschiedenen Distinktivitätsmaße zu erreichen und Verbesserungen in deren Implementierung und Anwendung vorschlagen zu können, werden wir geeignete Referenzkorpora erstellen und veröffentlichen, ein breites Spektrum an existierenden Distinktivitätsmaßen analysieren und deren statistische Eigenheiten bestimmen und vergleichen sowie sie in einem gemeinsamen konzeptionellen Modell formal darstellen. Basierend auf diesem Modell werden wir diese Maße in einem gemeinsamen Rahmen implementieren; zudem werden wir mehrere Evaluationsstrategien anwenden, um die Eigenschaften und die Leistungsfähigkeit der Maße empirisch zu ermitteln und zu vergleichen. Anschließend werden wir sie in einer ausführlichen Anwendungsstudie auf verschiedene Untergattungen des zeitgenössischen französischen Romans anwenden (auf kanonisierte Romane im Vergleich mit Populärliteratur wie Kriminalromane, Liebesromane und Science- Fiction-Romane). Abschließend werden wir die Hauptergebnisse der Studie in einer akademischen Publikation und in Form eines interaktiven, pädagogischen Webportals verbreiten.
Trier University
Trier Center for Digital Humanities
Prof. Dr. Christof Schöch
E-Mail: schoech@uni-trier.de
Telefon: +49 (0)651-201 3264
Find out more at
Add your DH research project to the project showcase by submitting a short project description via the web form. Enter project data, a brief description, a graphic or visualization as well as a detailed description of the project content with technical assignment, addressees, added value, project managers, funding information and duration.

DisKo steht für Diversitäts-Korpus und ist ein literaturwissenschaftliches Projekt mit Digital-Humanities-Komponente. Mit Methoden des maschinellen Lernens wollen wir einen Algorithmus
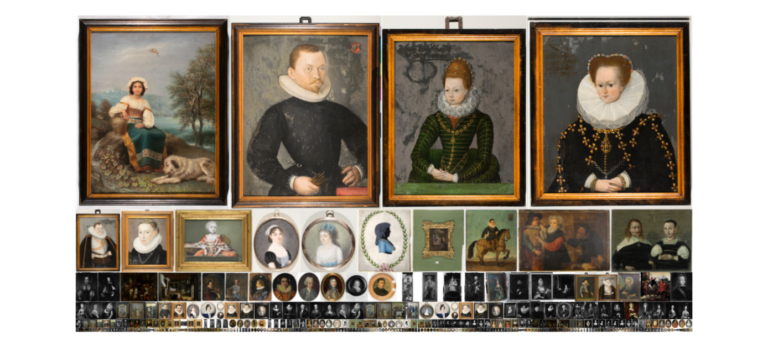
Das vom Bundesministerium für Bildung und Forschung (BMBF) geförderte und am UCLAB der FH Potsdam angesiedelte Projekt Restaging Fashion (11.2020
Die Edition „Hamburger Schlüsseldokumente zur deutsch-jüdischen Geschichte“ soll sowohl einem akademischen Publikum als auch der interessierten Öffentlichkeit einen niedrigschwelligen Zugang
Annotieren, Analysieren, Interpretieren und Visualisieren: In CATMA können Textwissenschaftler:innen so arbeiten, wie es ihren Fragestellungen am besten entspricht: qualitativ oder
Die Website „Der Holocaust in Ungarn und die Deportationen nach Norddeutschland“ präsentiert Ergebnisse aus dem transnationalen Projekt „Digitale Gedenk- und
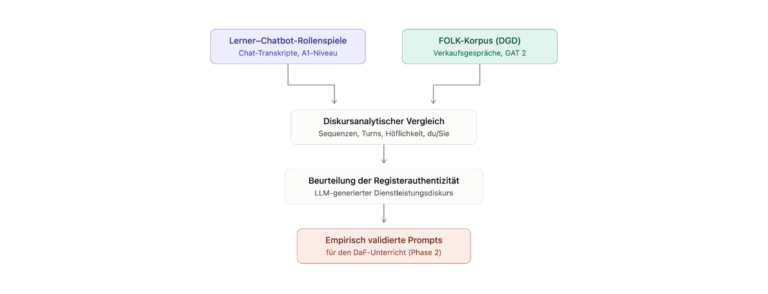
Im Rahmen eines Forschungsprojekts an der San Francisco State University untersuche ich, wie Deutschlernende auf Anfängerniveau (erstes Semester) simulierte Dienstleistungsgespräche
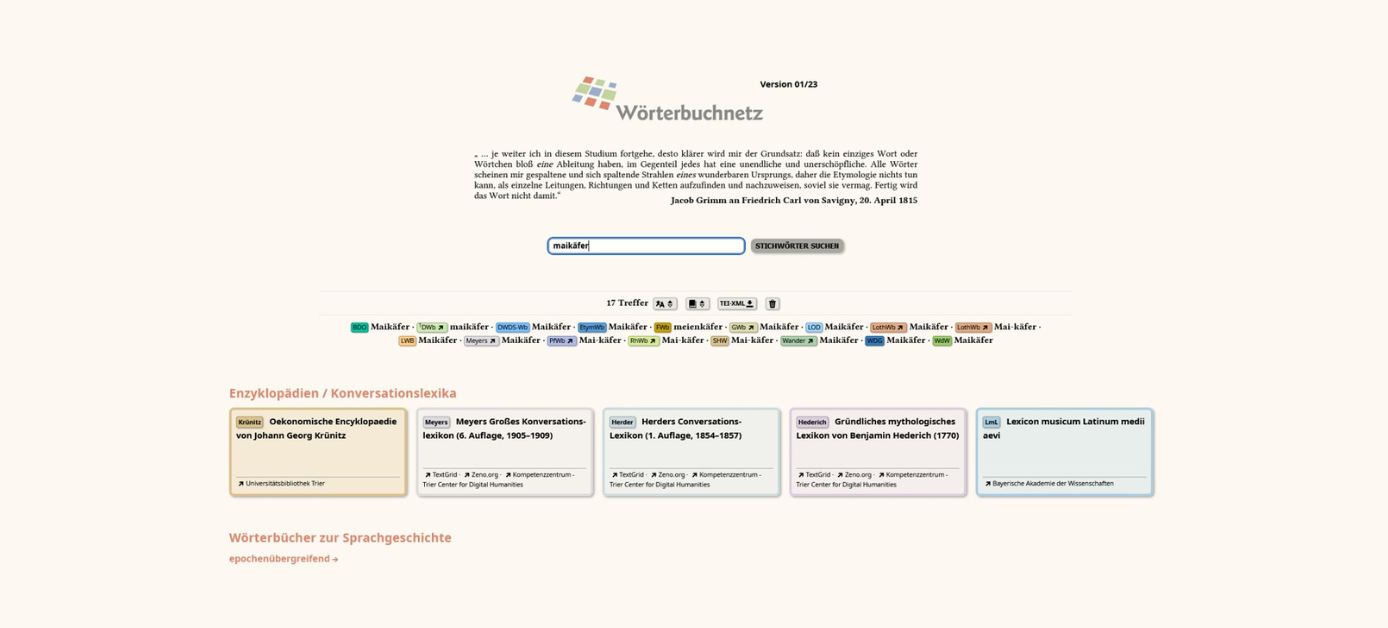
The Trier dictionary network offers access to more than 40 dictionaries and reference works, which can either be called up individually or queried together using a comprehensive search. At the same time, the dictionaries are interlinked at keyword level so that iterative navigation within the dictionary network is possible.
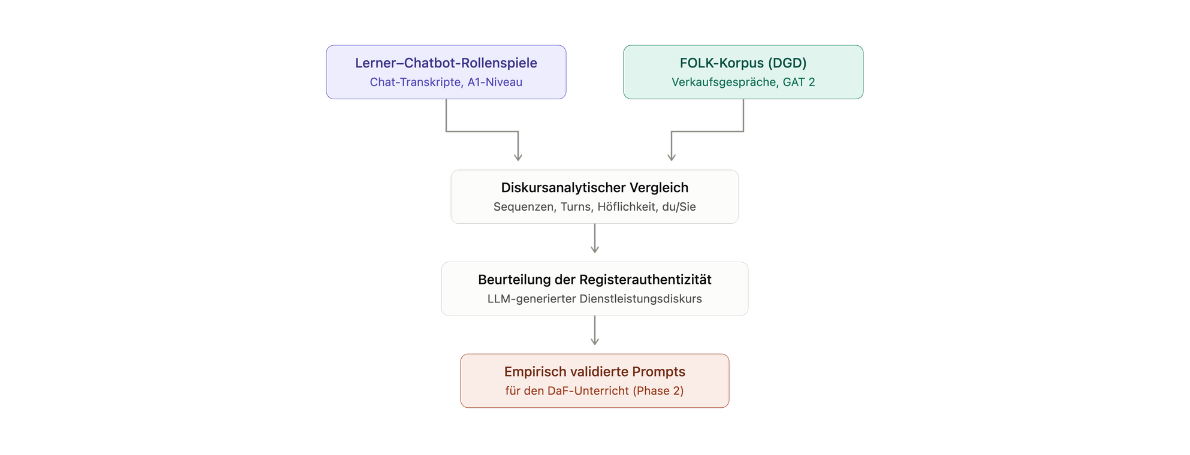
Im Rahmen eines Forschungsprojekts an der San Francisco State University untersuche ich, wie Deutschlernende auf Anfängerniveau (erstes Semester) simulierte Dienstleistungsgespräche
Wir verwenden Cookies und ähnliche Funktionen zur Verarbeitung von Daten. Die Zustimmung ist freiwillig und kann jederzeit widerrufen werden.