Das Projekt aggregiert Informationen zu digitalen Projekten und Konsortien, die sich im weitesten Sinne mit nicht-lateinischen Schriften beschäftigen. Die gesammelten
Short description of the project
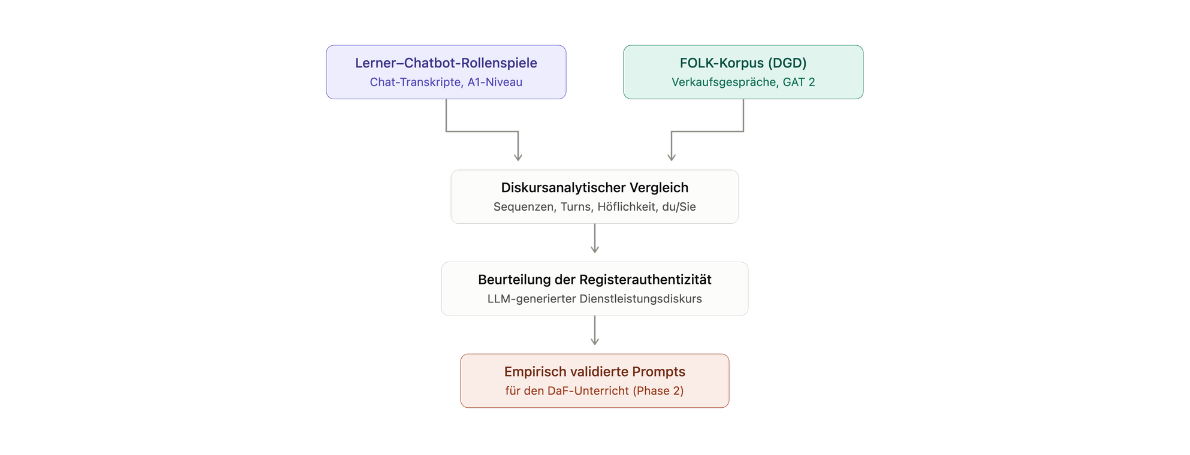
Forschungsprojekt zur diskursanalytischen Untersuchung von simulierten Dienstleistungsgesprächen (z. B. Bäckerei, Café, Fahrkartenschalter) zwischen Deutschlernenden auf Anfängerniveau und LLM-basierten Chatbots. Die FOLK-Daten aus dem Bereich Dienstleistungen dienen als authentische Vergleichsbasis (Gesprächsstruktur, Eröffnungen/Beendigungen, Aufforderungsformate, Turn-Länge, Höflichkeit/Direktheit, Anredeformen), um die Registerauthentizität der Chatbot-Interaktionen zu beurteilen und empirisch fundierte Prompts für den DaF-Unterricht zu entwickeln. Nutzung ausschließlich für Forschung und Lehre.
Project content
Im Rahmen eines Forschungsprojekts an der San Francisco State University untersuche ich, wie Deutschlernende auf Anfängerniveau (erstes Semester) simulierte Dienstleistungsgespräche — etwa Einkaufsgespräche in der Bäckerei, Bestellungen im Café oder Fahrkartenkäufe — mit LLM-basierten Chatbots führen. Das Projekt verbindet gesprächsanalytische und diskursanalytische Methoden mit Fragestellungen der Zweitspracherwerbsforschung (Bedeutungsaushandlung, formelhafte Sprache, pragmatische Routinen). Die Transkripte des FOLK-Korpus aus dem Bereich Dienstleistungen (insbesondere Verkauf, Restaurant) sollen als authentische Vergleichsgrundlage dienen: Verglichen werden sequenzielle Struktur (Gesprächseröffnung und -beendigung, Aufforderungsformate, Abschlusssequenzen), Turn-Länge, Direktheit und Höflichkeitsmarkierungen sowie Anredeformen (du/Sie) in authentischen Dienstleistungsgesprächen einerseits und in Chatbot-generierten Rollenspielen andererseits. Ziel ist es, die Registerauthentizität LLM-generierter Dienstleistungsdiskurse zu beurteilen und darauf aufbauend empirisch validierte Prompts für den technologiegestützten DaF-Unterricht zu entwickeln. Die Daten werden ausschließlich zu Forschungs- und Lehrzwecken genutzt; in Publikationen werden allenfalls kurze Belegausschnitte mit korrekter Quellenangabe zitiert.
Ilona Vandrgriff
San Francisco State University
Add your DH research project to the project showcase by submitting a short project description via the web form. Enter project data, a brief description, a graphic or visualization as well as a detailed description of the project content with technical assignment, addressees, added value, project managers, funding information and duration.

Das Projekt aggregiert Informationen zu digitalen Projekten und Konsortien, die sich im weitesten Sinne mit nicht-lateinischen Schriften beschäftigen. Die gesammelten
Die digitale Ausgabe der Werke Friedrichs des Großen der Universitätsbibliothek Trier bietet eine XML-konforme und recherchierbare elektronische Volltextversion der von
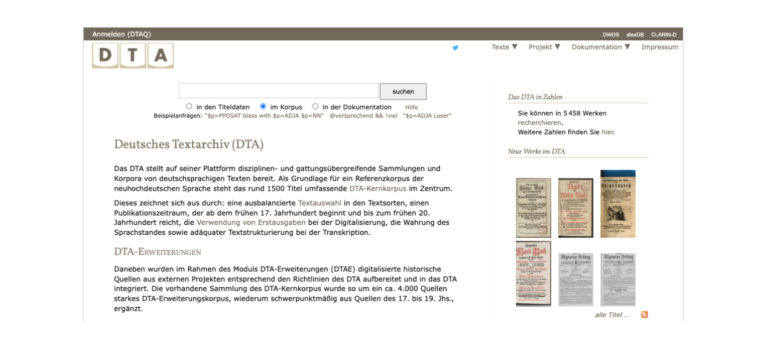
Das DTA ist ein Archiv für deutschsprachige, historische Textsammlungen an der Berlin-Brandenburgischen Akademie der Wissenschaften. Es umfasst annotierte Volltexttranskriptionen von
Der DARIAH-DE Geo-Browser ermöglicht eine vergleichende Visualisierung mehrerer Anfragen und unterstützt die Darstellung von Daten und deren Visualisierung in einer
is in die 1990er Jahre war es in der Filmwissenschaft ein Gemeinplatz, dass Frauen in den Anfangsjahren der Filmproduktion nur
Annotieren, Analysieren, Interpretieren und Visualisieren: In CATMA können Textwissenschaftler:innen so arbeiten, wie es ihren Fragestellungen am besten entspricht: qualitativ oder
Die Virtuelle Forschungsumgebung TextGrid ist optimiert für die digitale Erschließung geisteswissenschaftlicher Quellen und deren langfristige Archivierung in einem Web-Archiv, insbesondere von TEI-codierten Ressourcen
Im Rahmen eines Forschungsprojekts an der San Francisco State University untersuche ich, wie Deutschlernende auf Anfängerniveau (erstes Semester) simulierte Dienstleistungsgespräche
Wir verwenden Cookies und ähnliche Funktionen zur Verarbeitung von Daten. Die Zustimmung ist freiwillig und kann jederzeit widerrufen werden.