Der Arbeitskreis organsiert das #ArthistoCamp, die Schriftenreihe Computing in Art and Architecture und den #arthistocast – der Podcast zur Digitalen
Short description of the project
Mit correspSearch können Wissenschaftler:innen mehrere Hundert digitale und gedruckte Briefeditionen durchsuchen, u.a. anhand von Korrespondenzpartner:in, Ort, Datum und Volltext. Durch verschiedene Filter und Visualisierungen (Zeitverlauf, Karte und Netzwerk) kann das Suchergebnis exploriert oder weiter eingegrenzt werden. Die aggregierten Daten sind auch über verschiedene Schnittstellen automatisiert abfragbar und unter einer freien Lizenz nachnutzbar.
Project content
Der Webservice correspSearch wurde entwickelt um ein lange bestehendes Desiderat von Briefeditionen zu beheben: Die edierten Briefe editionsübergreifend durchsuchen zu können.
Die Korrespondenzmetadaten der edierten (oder anderweitig wissenschaftlich erschlossenen) Briefe werden dabei i.d.R. von den Editionsvorhaben selbst im Correspondence Metadata Interchange Format (CMIF) bereitgestellt. Das CMIF wurde von der Special Interest Group „Correspondence“ der Text Encoding Initiative entwickelt und basiert im Wesentlichen auf der Erweiterung ‚correspDesc‘ der TEI-Richtlinien. Außerdem verwendet es zur projektübergreifenden Identifizierung von Personen, Körperschaften und Orten URIs aus Normdateien, wie der Gemeinsamen Normdatei oder GeoNames. Die durch correspSearch aggregierten CMIF-Daten werden harmonisiert und angereichert (z.B. mit Informationen über das Geschlecht). Nutzer:innen können Briefe u.a. anhand der Kriterien Absender:in, Empfänger:in, Ort, Zeitraum, Geschlecht, Beruf (anhand der GND-Daten) suchen – natürlich auch beliebig kombiniert. Seit Sommer 2024 ist auch eine Volltextsuche in den Editionen möglich, die ihre Volltextdaten als TEI-XML bereitstellen. Dabei wird in der Anzeige zwischen Treffern im Regest, Brieftext und Herausgeberkommentar unterschieden. Das Suchergebnis kann über (eigens durchsuchbare) Facetten weiter gefiltert werden. Gleichzeitig besteht auch die Möglichkeit, die Treffermenge in drei Visualisierungen – Zeitverlauf, Topographie und Netzwerk – zu explorieren. Dabei können auch wiederum Teilmengen und einzelne Briefe ausgewählt werden.
Neben der Rechercheoberfläche stellt correspSearch auch verschiedene Schnittstellen bereit, über die der Datenbestand automatisiert abgefragt und maschinenlesbar bezogen werden kann. Dabei werden verschiedene APIs angeboten, etwa in TEI-XML, TEI-JSON oder CSV. Über die Plattform LOD.ACADEMY sind die aggregierten Metadaten darüberhinaus auch als Linked Open Data abrufbar.
Editionsvorhaben, die Daten für correspSearch bereitstellen möchten, können sich anhand von Erklärvideos, der CMIF-Dokumentation und weiteren Anleitungen informieren. Tools rund um CMIF, die in der Community entwickelt wurden, sind verlinkt. Mit Hilfe des CMIF Creators kann jeder ohne technische Vorkenntnisse Daten für correspSearch beisteuern. Das Widget csLink vernetzt automatisiert auf Ebene der einzelnen Briefe verschiedene digitale und gedruckte Editionen miteinander. Es kann frei nachgenutzt und in der eigenen digitalen Edition implementiert werden.
CorrespSearch wird seit 2014 von der Berlin-Brandenburgischen Akademie der Wissenschaften betrieben. Die Entwicklung wurde von der DFG gefördert.
correspSearch – Briefeditionen durchsuchen und vernetzen
Berlin-Brandenburg Academy of Sciences
E-Mail: correspSearch@bbaw.de
Find out more at
https://correspsearch.net
Add your DH research project to the project showcase by submitting a short project description via the web form. Enter project data, a brief description, a graphic or visualization as well as a detailed description of the project content with technical assignment, addressees, added value, project managers, funding information and duration.

Der Arbeitskreis organsiert das #ArthistoCamp, die Schriftenreihe Computing in Art and Architecture und den #arthistocast – der Podcast zur Digitalen
Das forTEXT Portal bietet einsteigerfreundlich aufbereitete, zitierfähige Methodenbeschreibungen und Reviews von Textsammlungen und Tools – von Digitalisierung über Annotation zu
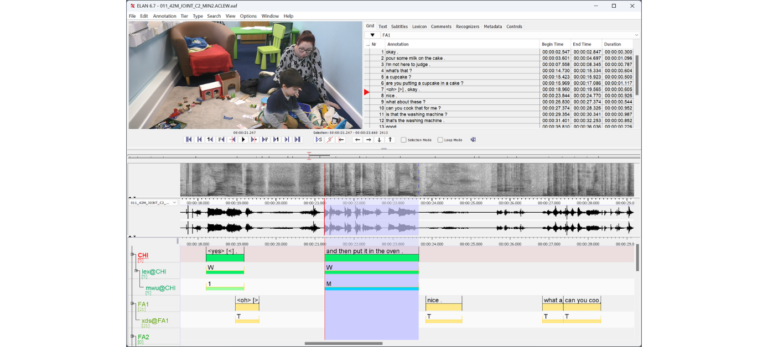
ELAN wird am Max-Planck-Institut für Psycholinguistik im Sprach-Archiv (TLA – The Language Archive) entwickelt. Es wird in der Programmiersprache Java
GAMS ist ein OAIS-konformes Repositorium zur Verwaltung, Publikation und Langzeitarchivierung digitaler Ressourcen aus allen geisteswissenschaftlichen Fächern.
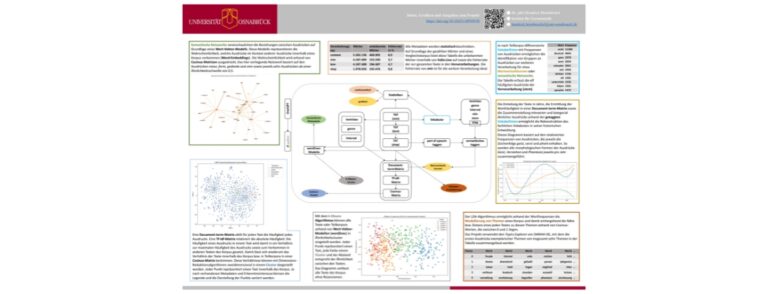
Das Projekt untersucht den öffentlich-schriftlichen Diskurs der Literaturvermittlung an höheren Schulen im 19. Jahrhundert für alle deutschen Staaten – außer
Das Ziel der Bibliotheca legum ist es, einen Überblick über die handschriftliche Produktion weltlichen Rechts in der Karolingerzeit zu geben.
Digital edition of the economic-technological encyclopaedia by J. G. Krünitz, published in 242 volumes from 1773 to 1858.
Dietrich online provides bibliographical information on approximately 5 million journal articles and newspaper articles published in the German-speaking world between 1897 and 1944 in an online database searchable by author name, title keywords, German-language keywords, journal or newspaper titles and year of publication.
Wir verwenden Cookies und ähnliche Funktionen zur Verarbeitung von Daten. Die Zustimmung ist freiwillig und kann jederzeit widerrufen werden.