Das Fach ist BUA-finanziert und am Seminar für Semitistik und Arabistik angelegt. Es fokussiert sich auf die Analyse des status
Kurzbeschreibung des Projekts
Annotieren, Analysieren, Interpretieren und Visualisieren: In CATMA können Textwissenschaftler:innen so arbeiten, wie es ihren Fragestellungen am besten entspricht: qualitativ oder quantitativ, bottom-up und explorativ oder deskriptiv und taxonomiebasiert, einzeln oder im Team. Das webbasierte Open Source Tool ist kostenfrei und bietet außerdem die Möglichkeit, eigene Daten zu exportieren, um sie zum Beispiel mit anderen Tools weiter zu verarbeiten.
Das Tool wird seit 2008 kontinuierlich weiterentwickelt. CATMA 7 wurde innerhalb des von der Stiftung Innovation in der Hochschullehre (StIL) geförderten Projektes forTEXT Portal (https://fortext.net) entwickelt und im Mai 2023 veröffentlicht.
Projektinhalt
CATMA kennt kein Dogma, ist Open Source, kostenlos verfügbar und webbasiert. Das Annotationstool ist projektzentriert und erlaubt das Arbeiten mit Texten in allen gängigen Dateiformaten und in den meisten Sprachen, inkl. Sprachen, die von rechts nach links geschrieben werden. Nutzer:innen können ihr eigenes Korpus hochladen, es mit einem Team teilen und kollaborativ an ihm arbeiten. Es können beliebig viele Projekte erstellt werden.
Es gibt in CATMA neben dem Projektmodul drei wesentliche Arbeitsbereiche: „Annotate“, „Tags“ und „Analyze“:
Texte, Annotationen, Abfrage-Ergebnisse und Visualisierungen können in unterschiedlichen Formaten exportiert werden. Außerdem ist der Zugriff auf die “rohen” Daten jederzeit gewährleistet.
Das erstmals 2021 veröffentlichte Python-Package GitMA, welches als Erweiterung von CATMA angesehen werden kann, nutzt den oben genannten Zugriff auf die rohen Daten, um — mithilfe von gängigen Python Data-Science-Tools — die weitere Prozessierung, Analyse und Manipulation dieser Daten zu ermöglichen. Dazu gehören vor allem Funktionen, die den (visuellen) Vergleich von Annotationen verschiedener Annotator:innen, die Berechnung von Inter-Annotator-Agreement-Werten und die Erstellung von Gold-Annotationen ermöglichen.
Auf der zugehörigen CATMA-Webseite finden sich FAQs, Tutorials, ein Manual, ein Glossar sowie umfassende Informationen zur technischen Dokumentation und Kontaktinformationen für den Nutzer:innen-Support.
Malte Meister
Technische Universität Darmstadt
Institut für Sprach- und Literaturwissenschaft
Residenzschloss 1
64283 Darmstadt
E-Mail: team@catma.de
Erfahren Sie mehr unter
Fügen Sie Ihr DH-Forschungsprojekt dem Projektschaufenster hinzu, indem Sie eine kurze Projektbeschreibung über das Webformular einreichen. Geben Sie Projektdaten, eine Kurzbeschreibung, eine Grafik oder Visualisierung sowie eine detaillierte Beschreibung des Projektinhalts mit fachlicher Zuordnung, Adressaten, Mehrwert, Projektverantwortlichen, Finanzierungsinformationen und Laufzeit an.

Das Fach ist BUA-finanziert und am Seminar für Semitistik und Arabistik angelegt. Es fokussiert sich auf die Analyse des status
Das Hidden Kosmos – Reconstructing Alexander von Humboldt’s »Kosmos-Lectures« widmete sich von 2014–16 der Ermittlung und Verzeichnung, Bild- und Volltext-Digitalisierung
Die Website schafft einen schnellen und unkomplizierten Zugang zu den Werkmaterialien des österreichischen Literaturnobelpreisträgers Peter Handke.
Der Vergleich als methodisches und epistemologisches Paradigma ist in den Geisteswissenschaften tief verankert. Ob in der qualitativen oder quantitativen Forschung
Annotieren, Analysieren, Interpretieren und Visualisieren: In CATMA können Textwissenschaftler:innen so arbeiten, wie es ihren Fragestellungen am besten entspricht: qualitativ oder
Die Virtuelle Forschungsumgebung TextGrid ist optimiert für die digitale Erschließung geisteswissenschaftlicher Quellen und deren langfristige Archivierung in einem Web-Archiv, insbesondere
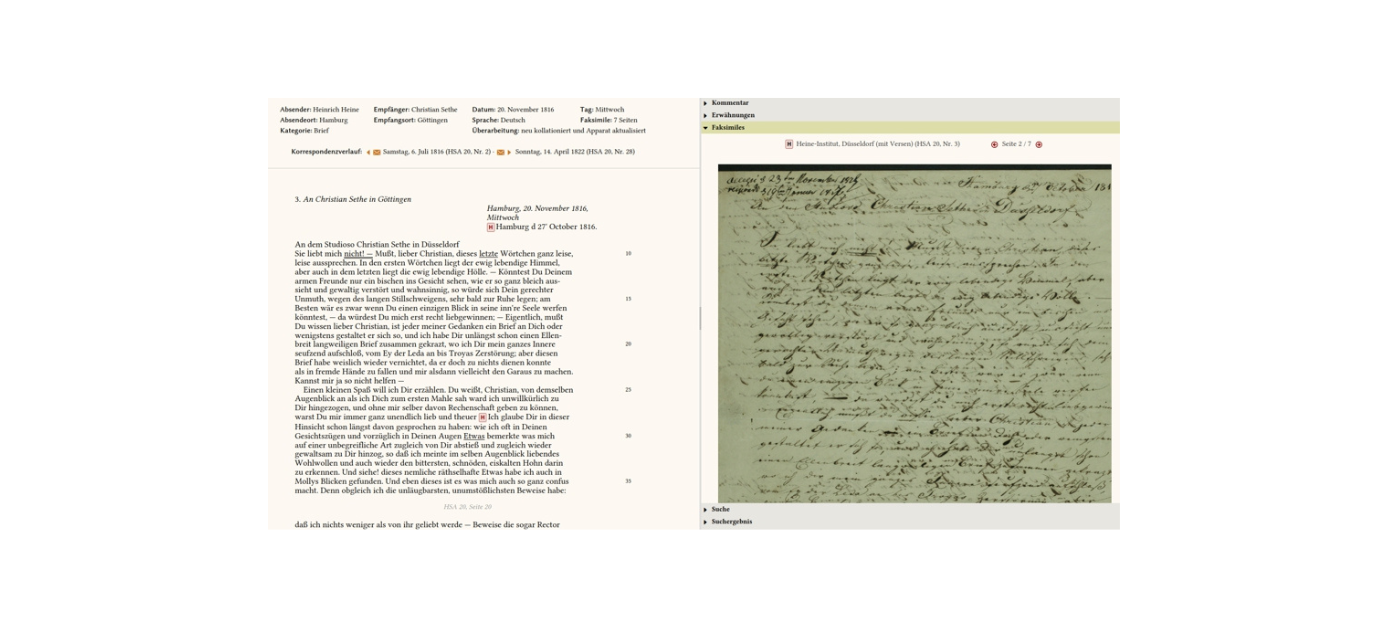
Das Heinrich-Heine-Portal schöpft aus den Arbeitsergebnissen mehrerer Forschergenerationen, indem es die beiden historisch-kritischen Heine-Gesamtausgaben, die unabhängig voneinander in der Bundesrepublik und der DDR entstanden, in einer digitalen Edition vereint.
Im Zentrum steht die Erforschung digitaler, datenintensiver Medien, die sich auf breiter Front als kooperative Werkzeuge, Plattformen und Infrastrukturen herausgestellt haben und im Kontext ubiquitärer Verdatung durch Sensortechnologien und semi-autonom operierender künstlicher Intelligenz auf neue Weise virulent werden. In diesem Spannungsfeld leistet der SFB digitale Grundlagenforschung, die zwischen Geschichte und Gegenwart vermittelt und zukünftige digitale Medien gestaltet.
Wir verwenden Cookies und ähnliche Funktionen zur Verarbeitung von Daten. Die Zustimmung ist freiwillig und kann jederzeit widerrufen werden.